Quando a IA erra, quem responde? O desafio de integrar modelos probabilísticos a sistemas determinísticos
A Inteligência Artificial está mudando a maneira como desenvolvemos software. Hoje, conseguimos construir aplicações que interpretam linguagem natural, compreendem documentos, identificam intenções e interagem com sistemas corporativos de forma cada vez mais sofisticada.
Mas existe uma questão que considero fundamental nessa evolução: até onde podemos confiar decisões de negócio a sistemas cuja natureza é probabilística?
Essa reflexão surgiu durante meus estudos na disciplina Aplicação de Inteligência Artificial, do mestrado em Inteligência Artificial da American Global Tech University (AGTU).
O tema proposto para discussão era o desafio de transformar modelos de IA em sistemas confiáveis de produção. Entre as diferentes questões arquiteturais apresentadas, uma chamou especialmente minha atenção: o determinismo na integração entre modelos generativos e sistemas empresariais.
Como engenheiro de software e profissional de arquitetura de soluções, vejo nessa discussão uma conexão direta com problemas que já enfrentamos há anos no desenvolvimento de sistemas distribuídos.
A diferença é que agora estamos introduzindo um componente capaz de interpretar e propor ações, mas que não oferece, por si só, as mesmas garantias de previsibilidade que esperamos de nossas regras de negócio.
O conflito entre dois mundos
Em sistemas empresariais tradicionais, determinadas operações precisam produzir resultados previsíveis.
Um cálculo de juros deve respeitar a fórmula estabelecida. Uma transferência bancária precisa obedecer aos limites e às autorizações aplicáveis. Um desconto comercial não pode ultrapassar o percentual permitido pela política da empresa.
Essas operações são determinísticas: considerando os mesmos dados, regras e estado do sistema, esperamos resultados consistentes e verificáveis.
Já os modelos de linguagem, conhecidos como LLMs (Large Language Models), operam de outra maneira.
Eles produzem respostas com base em padrões aprendidos e mecanismos probabilísticos de geração. Isso significa que uma resposta aparentemente coerente não é necessariamente correta, autorizada ou compatível com as regras de negócio.
Mesmo utilizando instruções cuidadosamente elaboradas, não podemos considerar um prompt como equivalente a uma regra implementada e validada no backend.
E é justamente nesse ponto que a arquitetura de software se torna decisiva.
A IA deve interpretar, mas não necessariamente decidir
Imagine um assistente inteligente integrado ao sistema financeiro de uma instituição.
Um cliente faz a seguinte solicitação:
"Gostaria de simular um empréstimo de R$ 50 mil para pagar em 36 meses."
Um modelo de IA pode identificar a intenção, extrair o valor solicitado, reconhecer o prazo e conduzir a interação de maneira natural.
Até aqui, estamos aproveitando uma das maiores vantagens da IA generativa: sua capacidade de transformar linguagem humana em informações estruturadas.
Entretanto, o modelo não deveria calcular livremente as condições do empréstimo, inventar uma taxa de juros ou decidir pela aprovação do crédito.
Essas responsabilidades pertencem a componentes especializados, capazes de aplicar regras financeiras, políticas de risco, restrições contratuais e exigências regulatórias.
O modelo pode solicitar uma simulação. Mas quem executa o cálculo é o serviço financeiro.
O modelo pode explicar o resultado. Mas quem determina a elegibilidade é o mecanismo responsável pela análise de crédito.
O modelo pode orientar o cliente durante a contratação. Mas a efetivação da operação precisa seguir um fluxo de autorização independente.
A distinção fundamental está entre compreender uma solicitação e possuir autoridade para executá-la.
Function calling não é uma autorização de negócio
Uma das técnicas utilizadas na integração de LLMs com sistemas corporativos é o function calling.
Por meio dela, o modelo pode solicitar a utilização de ferramentas ou funções disponibilizadas pela aplicação.
Por exemplo, ao identificar que o cliente deseja simular um empréstimo, o modelo poderia gerar uma chamada estruturada semelhante a esta:
{
  "tool": "simular_emprestimo",
  "arguments": {
    "valor": 50000,
    "parcelas": 36
  }
}
Esse mecanismo facilita a integração entre linguagem natural e funcionalidades empresariais.
Porém, existe um detalhe importante: o fato de o modelo solicitar uma função não significa que essa função esteja autorizada a ser executada.
A aplicação precisa validar os argumentos, verificar a identidade do usuário, analisar suas permissões e aplicar as políticas de negócio antes de realizar qualquer operação.
O modelo não deve conseguir contornar essas verificações, mesmo quando produz uma chamada sintaticamente válida.
Em outras palavras, o function calling deve ser tratado como uma solicitação de execução, não como uma concessão de autoridade.
Como eu estruturaria essa arquitetura?
Pensando em um ambiente corporativo, adotaria uma arquitetura com responsabilidades bem definidas.
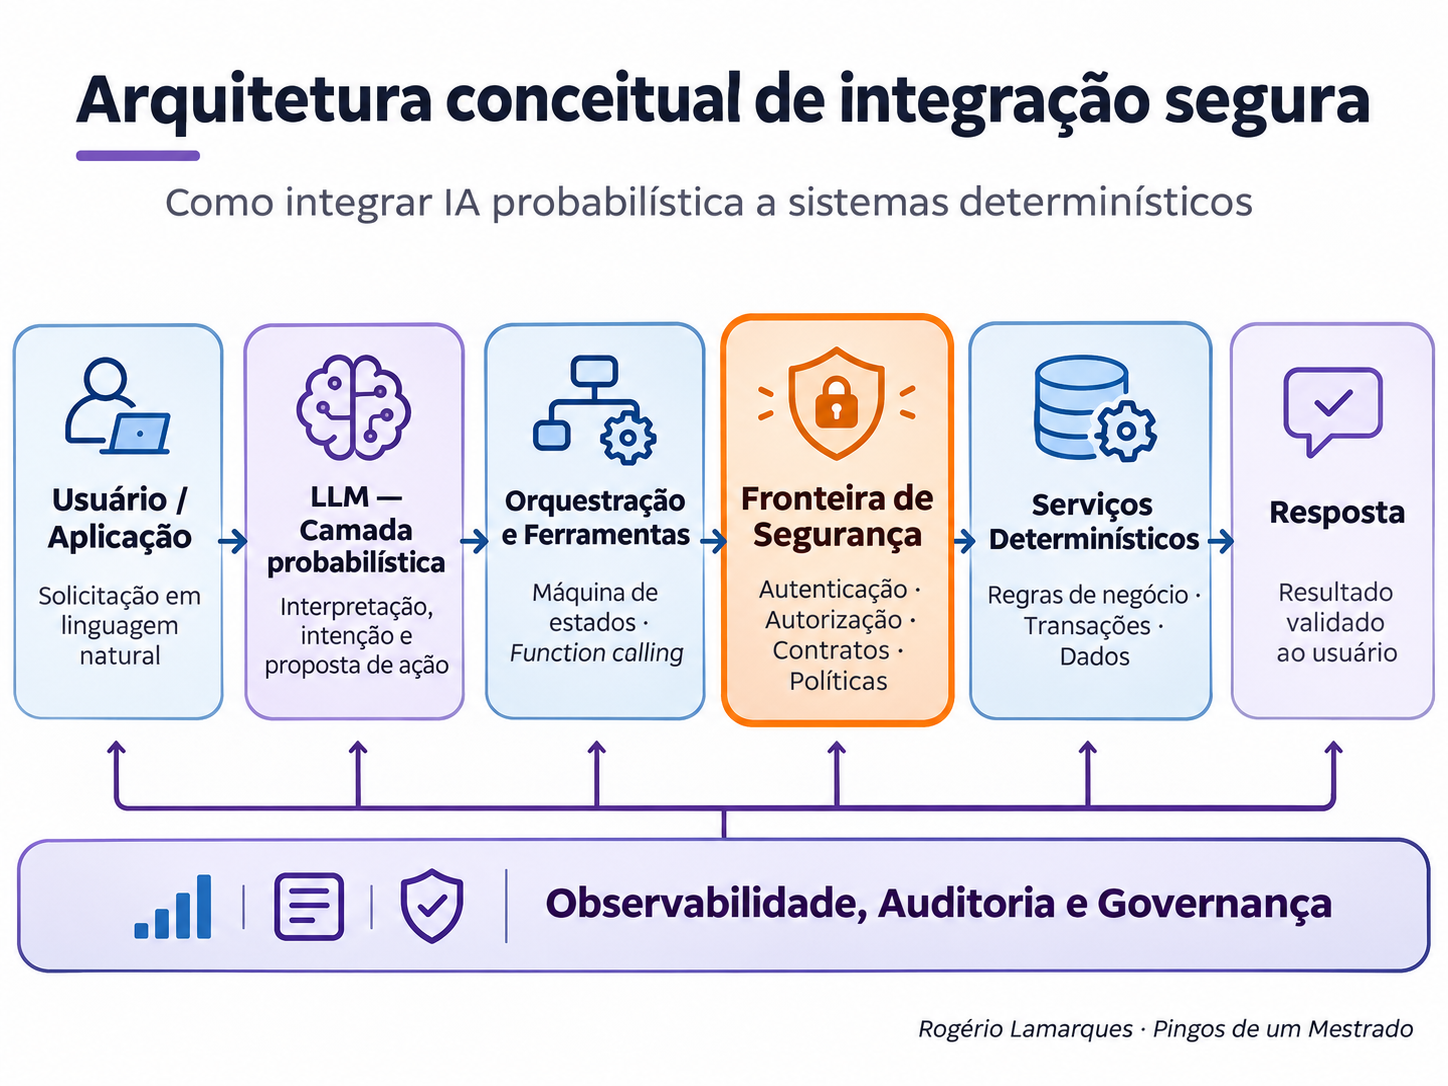
Figura 1 — Arquitetura conceitual de integração segura entre modelos probabilísticos de IA e serviços determinísticos. Elaboração própria — Rogério Lamarques (2026).
A primeira camada seria responsável pela interação com o usuário. Nela, o LLM interpreta solicitações, identifica intenções e apresenta respostas.
A segunda camada seria de orquestração, controlando quais ferramentas podem ser utilizadas e quais transições são permitidas no fluxo da aplicação.
Em seguida, uma camada de integração validaria os contratos de entrada, a identidade, as permissões e as políticas necessárias para executar cada operação.
Por último, os serviços de domínio continuariam responsáveis pelas regras de negócio e pela persistência das operações.
O fluxo seria:
Usuário → LLM → Orquestração → Validação e Autorização → Serviços de Domínio → Resposta
Essa separação permite utilizar a flexibilidade da IA sem abrir mão de princípios consolidados da engenharia de software, como separação de responsabilidades, menor privilégio, integridade transacional e rastreabilidade.
Também utilizaria máquinas de estado para controlar processos que exigem uma sequência obrigatória.
No exemplo financeiro, a contratação poderia depender das etapas de identificação, simulação, análise de elegibilidade, apresentação das condições, aceite e confirmação.
O LLM poderia ajudar o usuário a percorrer essas etapas, mas não deveria possuir autonomia para ignorá-las.
Outro cuidado seria impedir que saídas do modelo fossem utilizadas diretamente como comandos de banco de dados, instruções de infraestrutura ou operações financeiras sem validação e autorização independentes.
Guardrails: necessários, mas não suficientes
Outro conceito importante são os guardrails, mecanismos utilizados para restringir entradas, saídas e comportamentos de sistemas de IA.
Eles ajudam a identificar solicitações inadequadas, impedir determinadas respostas e validar formatos esperados.
No entanto, acredito que exista um risco em confiar excessivamente em controles que dependem do próprio modelo.
Se uma regra financeira é crítica, não basta instruir o LLM a respeitá-la. Essa regra precisa existir em um componente independente, capaz de rejeitar qualquer tentativa de violação.
Além disso, precisamos considerar ameaças como prompt injection, nas quais instruções maliciosas podem ser inseridas em documentos, mensagens ou conteúdos recuperados pelo sistema para tentar alterar seu comportamento.
Por isso, segurança em aplicações de IA não deve ser confundida com engenharia de prompts.
A segurança precisa estar presente na arquitetura, nos contratos, nas autorizações, no isolamento de execução e nas políticas de acesso aos recursos.
E quando o sistema precisa de intervenção humana?
Nem todas as operações exigem o mesmo nível de supervisão.
Uma consulta sobre o horário de funcionamento de uma empresa apresenta riscos muito diferentes de uma solicitação de transferência financeira ou alteração contratual.
Assim, a autonomia concedida à IA precisa ser proporcional ao impacto da ação.
Em operações de baixo risco, um fluxo automatizado pode ser suficiente.
Em situações de maior criticidade, mecanismos de confirmação explícita ou revisão humana podem ser necessários.
Esse padrão, conhecido como human-in-the-loop, permite que decisões sensíveis sejam submetidas à avaliação de uma pessoa responsável.
Entretanto, também é importante reconhecer que adicionar revisão humana indiscriminadamente pode tornar uma aplicação lenta e operacionalmente inviável.
O desafio arquitetural está em determinar quais decisões podem ser automatizadas, quais exigem validações adicionais e quais dependem obrigatoriamente de intervenção humana.
Observabilidade e governança não são opcionais
Quando um sistema tradicional apresenta um erro, geralmente investigamos logs, métricas, traces e eventos para compreender o que aconteceu.
Com aplicações baseadas em IA, essa necessidade permanece, mas ganha novas dimensões.
Precisamos saber qual versão do modelo foi utilizada, quais ferramentas foram solicitadas, quais validações ocorreram e por que determinada operação foi aceita ou rejeitada.
Também é necessário avaliar continuamente a qualidade das respostas, a ocorrência de falhas, o comportamento diante de entradas adversariais e os impactos de alterações nos modelos ou prompts.
Isso aproxima a engenharia de IA das práticas de MLOps e LLMOps, nas quais avaliação, versionamento, monitoramento e governança fazem parte do ciclo de vida da aplicação.
Um sistema pode funcionar corretamente durante os testes e apresentar comportamentos inesperados após mudanças de contexto, atualizações de modelos ou alterações nas fontes de informação.
Portanto, colocar uma aplicação de IA em produção não encerra seu desenvolvimento. Inicia uma nova etapa de responsabilidade operacional.
A arquitetura continua sendo nossa responsabilidade
Existe uma tendência de concentrar as discussões sobre IA na capacidade dos modelos: qual raciocina melhor, qual responde mais rápido ou qual apresenta menor custo.
Esses aspectos são importantes, mas não resolvem isoladamente os desafios de construir um sistema confiável.
Na prática, uma aplicação empresarial depende de muito mais do que um bom modelo.
Ela precisa de dados adequados, regras claras, integrações seguras, políticas de autorização, estratégias de recuperação diante de falhas e mecanismos contínuos de avaliação.
É nesse contexto que vejo uma transformação interessante no papel do arquiteto de software.
Não estamos simplesmente substituindo componentes tradicionais por modelos inteligentes. Estamos incorporando uma nova categoria de componente, com características próprias, a arquiteturas que continuam exigindo consistência, segurança e responsabilidade.
E isso requer compreender tanto as possibilidades quanto os limites da tecnologia.
Considerações finais
A principal reflexão que levo desse estudo é que a confiabilidade de um sistema de IA não pode depender exclusivamente da capacidade do modelo de seguir instruções.
Precisamos construir arquiteturas capazes de manter as regras de negócio e os limites de segurança mesmo quando o modelo interpreta incorretamente uma solicitação, produz informações inconsistentes ou tenta executar uma ação não autorizada.
A IA generativa pode tornar nossos sistemas mais acessíveis, flexíveis e inteligentes.
Mas a responsabilidade por garantir que essas capacidades sejam utilizadas de maneira segura continua sendo da engenharia.
Talvez essa seja uma das mudanças mais importantes na arquitetura de sistemas modernos: aprender a trabalhar com componentes probabilísticos sem abrir mão das garantias determinísticas que sustentam os negócios.
Afinal, quando a IA erra, quem responde não é apenas o modelo. É toda a arquitetura que permitiu que aquele erro produzisse consequências.
Referências e aprofundamento
HUYEN, Chip. Designing Machine Learning Systems: An Iterative Process for Production-Ready Applications. O'Reilly Media, 2022.
HUYEN, Chip. AI Engineering: Building Applications with Foundation Models. O'Reilly Media, 2025.
NATIONAL INSTITUTE OF STANDARDS AND TECHNOLOGY (NIST). Artificial Intelligence Risk Management Framework (AI RMF 1.0). 2023.
Este artigo faz parte da série Pingos de um Mestrado, na qual compartilho reflexões e conexões entre os conteúdos estudados no mestrado em Inteligência Artificial e os desafios práticos da engenharia de software e da arquitetura de soluções.
About the author
Sou Engenheiro de Software especializado em desenvolvimento Back-End, com mais de 15 anos de experiência profissional em PHP, atuando principalmente com os ecossistemas Laravel e Hyperf para construir APIs, sistemas distribuídos e aplicações de alta performance. Nos últimos anos, venho ampliando meu stack com C# e .NET, aplicando conceitos modernos de arquitetura, DDD, boas práticas e Clean Code para entregar soluções escaláveis e de longa manutenção. Tenho experiência com práticas DevOps, automação, integração contínua e pipelines que aceleram o ciclo de entrega. Gosto de criar software bem arquitetado, escrever código claro, e aproveitar o potencial da IA para acelerar desenvolvimento e documentação. No Hashnode, compartilho reflexões, estudos, tutoriais e experimentos sobre engenharia de software, arquiteturas modernas e uso de IA para aumentar a produtividade no desenvolvimento.
Comments
Join the discussionNo comments yet. Be the first to comment.